2Xiaomi MiMo-V2.5-Pro
Agent 能力与长程连贯性的飞跃
2026-07-03
Xiaomi MiMo-V2.5-Pro:Agent 能力与长程连贯性的飞跃
2026 年 4 月 27 日,我们正式发布并开源 MiMo-V2.5-Pro。MiMo-V2.5-Pro 是一个 1.02T 参数的混合专家模型,激活参数 42B,基于混合注意力架构构建,支持 100 万 token 上下文窗口。在通用 Agent 能力、复杂软件工程和长程任务方面相比前代 MiMo-V2-Pro 实现了显著提升。
01
为解决更难问题而生
MiMo-V2.5-Pro 为更高难、更复杂的任务目标而生。我们把那些需要人类专家数天、乃至数周才能完成的任务交给它,让它独立跑完长程,且仍然可以保持极高质量。以下是它交付的结果:
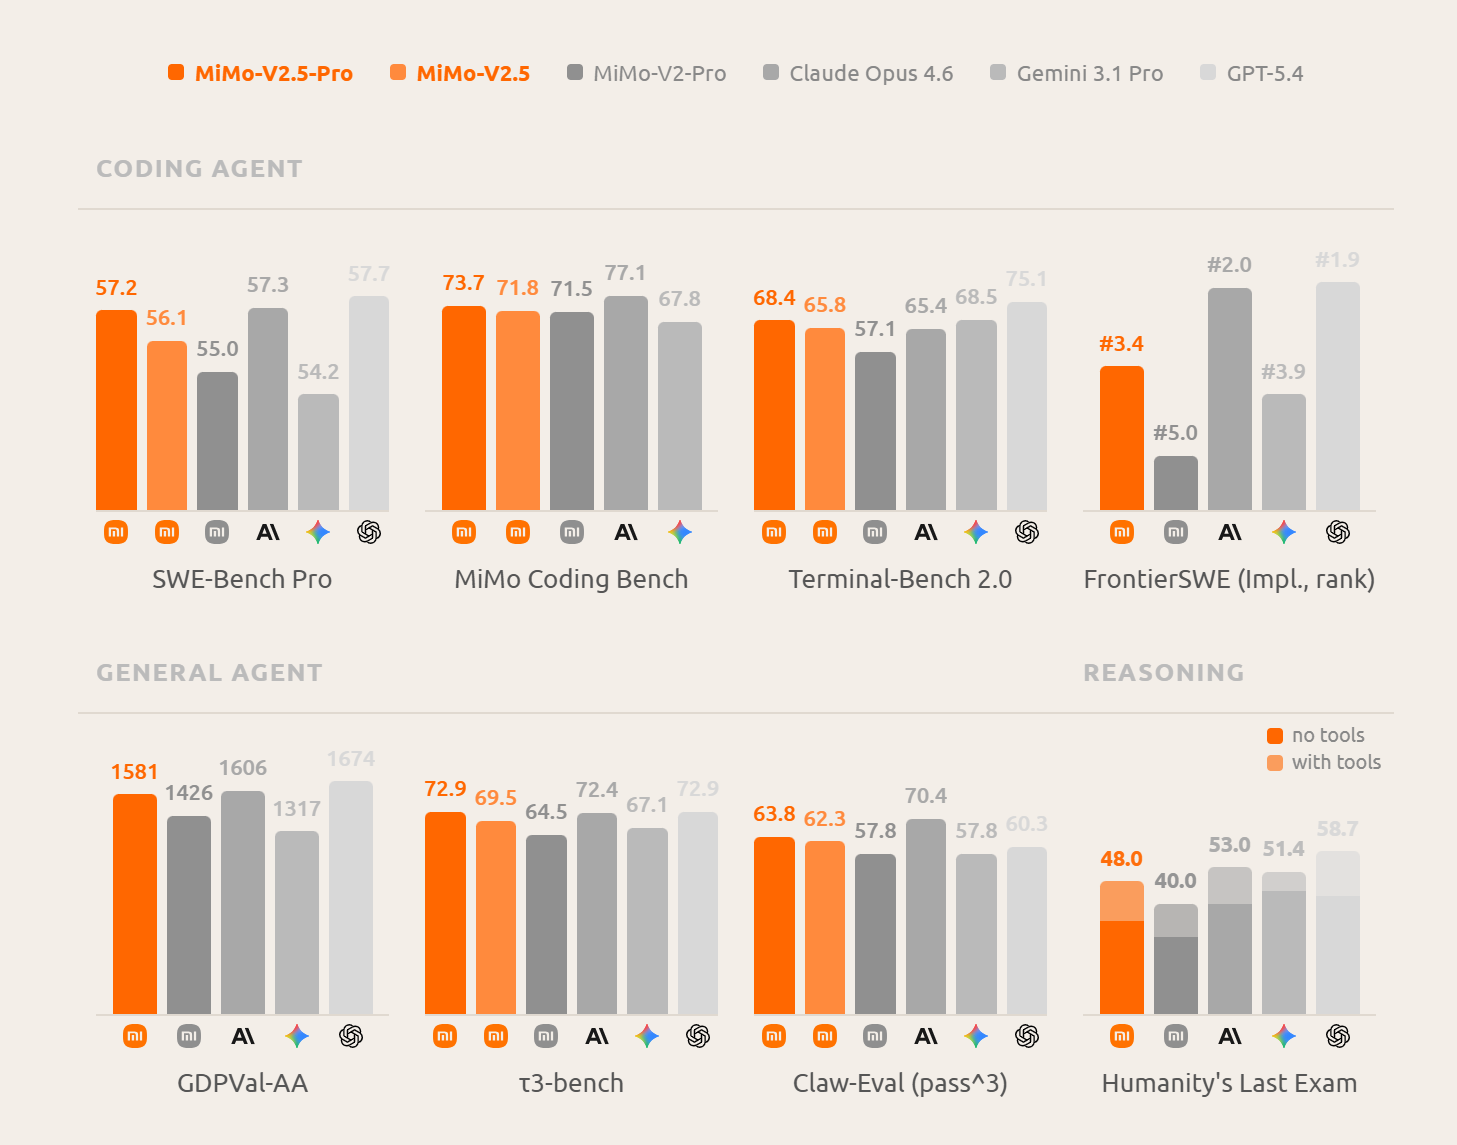
在内部测试中,V2.5-Pro 展现了全新的智能水平,促使我们的研究人员重新思考如何与它协作。在合适的框架配合下,V2.5-Pro 能够持续执行跨越上千次工具调用的复杂长程任务。我们在 Agent 场景中的指令遵循能力也看到了显著提升。它能够可靠地遵循嵌入上下文中的细微要求,并在超长上下文中保持强连贯性。
MiMo-V2.5-Pro 现已全面上线 Xiaomi MiMo 开放平台、AI Studio 等平台,价格不变。只需将模型名称替换为 mimo-v2.5-pro 即可开始使用。
01
为解决更难问题而生
MiMo-V2.5-Pro 为更高难、更复杂的任务目标而生。我们把那些需要人类专家数天、乃至数周才能完成的任务交给它,让它独立跑完长程,且仍然可以保持极高质量。以下是它交付的结果:
▎Rust 编写的 SysY 编译器
该任务源自北京大学《编译原理》课程项目,要求模型用 Rust 从零实现一个完整的 SysY 编译器:词法分析器、语法分析器、AST、Koopa IR 代码生成、RISC-V 汇编后端,以及性能优化。作为参考,计算机专业学生完成该项目通常需要数周时间,然而 MiMo-V2.5-Pro 用时仅 4.3 小时、经过 672 次工具调用完成全部工作,在隐藏测试集上取得 233/233 的满分,展现了极高效的生产力价值。
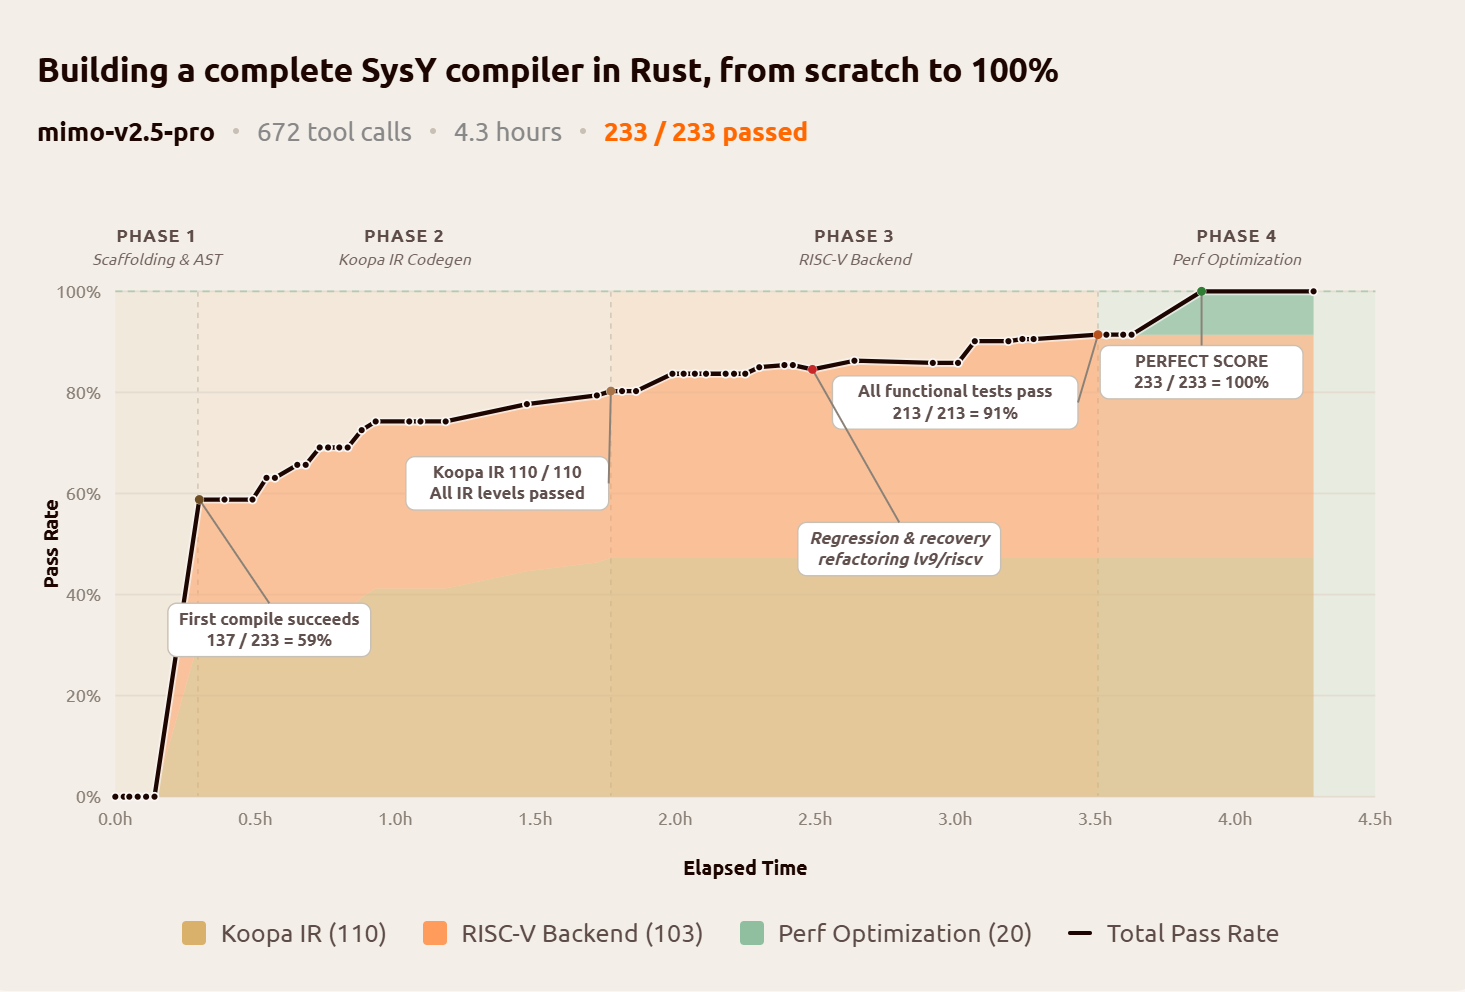
模型并非盲目试错,而是逐层构建编译器:先搭完整流水线骨架,再逐层攻克——Koopa IR 满分(110/110),RISC-V 后端满分(103/103),性能优化满分(20/20)。首次编译即通过 137/233,59% 的冷启动通过率,意味着在跑任何测试之前,架构就已经是对的。在第 512 轮时,一次重构导致 lv9/riscv 回退了两个测试;模型诊断了失败、恢复并继续推进。长程工作正是需要这种结构化的自我修正能力。
▎全功能视频编辑器
仅凭几句简单指令,MiMo-V2.5-Pro 就交付了一个可工作的桌面应用:多轨时间线、片段裁剪、交叉淡入淡出、音频混音和导出流程。最终构建的代码量达 8,192 行,历经 1,868 次工具调用,在 11.5 小时的自主工作中完成。
MiMo-V2.5-Pro 端到端编写的视频编辑器演示,包括由 MiMo-V2-TTS 驱动的 AI 配音。
▎模拟 EDA:FVF-LDO 设计与优化
一个研究生级别的模拟电路 EDA 任务:在台积电 180nm CMOS 工艺中从零设计和优化一个完整的 FVF-LDO(翻转电压跟随器低压差稳压器)。模型需要调整功率管尺寸、调谐补偿网络、选择偏置电压,使六个指标同时满足规格——相位裕度、线性调整率、负载调整率、静态电流、PSRR 和瞬态响应。训练有素的模拟设计师通常需要数天时间。我们将 MiMo-V2.5-Pro 接入 ngspice 仿真循环,以 Claude Code 作为 Agent Harness 框架。经过约一小时的闭环迭代——调用仿真器、读取波形、调整参数——模型产出了一个所有目标指标都满足的设计,下图所示的四个指标比其初始尝试提升了一个数量级。

在这些实验中,V2.5-Pro 展现了出色的"框架感知"能力:它充分利用框架环境的可供性,管理内存,并塑造自身上下文的填充方式以达成最终目标。
02
前沿编码智能
我们通过扩展后训练计算进一步提升了模型的编码智能。
MiMo Coding Bench 是我们的内部评测体系,用于评估模型在 Claude Code 等 Agent 框架内处理多样化编码任务的能力。涵盖仓库理解、项目构建、代码审查、结构化产物生成、规划、SWE 等。MiMo-V2.5-Pro 进一步提升了真实编码场景中的用户体验,更好地处理各种开发需求。

我们欢迎全球开发者将 MiMo-V2.5 系列集成到 Claude Code、OpenCode、Kilo 等 Agent 框架中——以更低成本获取顶尖智能。
03
Token 效率
更高的智能不仅仅是更高的分数——也要用更少的 token 达成目标。MiMo-V2.5-Pro 在达到前沿能力的同时,每项任务的 token 消耗大幅降低。在 ClawEval 上,V2.5-Pro 以每项任务仅约 70K token 实现 64% Pass^3——比能力相当的 Claude Opus 4.6、Gemini 3.1 Pro 和 GPT-5.4 节省约 40-60% 的 token。图表左上角为更佳:更低成本,更高分数。

04
开源
MiMo-V2.5-Pro 现已在 MIT 许可证下完全开源。权重、分词器和完整模型卡可在 Hugging Face 上获取。
▎模型规格

▎架构与训练
MiMo-V2.5-Pro 继承了 MiMo-V2-Flash 的混合注意力和多 Token 预测(MTP)设计。局部滑动窗口注意力(SWA)和全局注意力(GA)以 6:1 的比例交错,窗口大小 128 token,在长上下文中将 KV 缓存存储减少近 7 倍,同时通过可学习的注意力偏置保持性能。一个轻量级 MTP 模块(密集 FFN)原生集成用于训练和推理,输出吞吐量约提升 3 倍,RL 推演加速。
预训练使用 27T token,FP8 混合精度,原生 32K 序列长度,上下文扩展至 100 万 token。后训练遵循 MiMo-V2-Flash 引入的三阶段范式:
(1)监督微调,在精选数据对上建立基础指令遵循能力;
(2)领域专项训练,各独立教师模型通过领域特定 RL 分别优化数学、安全、Agent 工具使用等;
(3)多教师在策略蒸馏(MOPD),单一学生模型从自身推演中在策略学习,同时接受所有专家教师的 token 级指导,将它们的能力融合为一个统一模型。
详见 Hugging Face 上的模型卡了解架构细节、评测表格和 SGLang/vLLM 部署指南。
▎完整基准测试结果
最佳开源模型 最佳模型

除非特殊标注,否则越高越好。"—"代表未评测。DeepSeek V4 Pro 成绩使用其 max effort 设置。